AI Agents
Kubernetes × AI:推論からインテリジェンスへ、スケールするAI基盤の進化
かつてはコンテナオーケストレーターだったKubernetesが、AIワークロードのためのユニバーサルプラットフォームへと進化した軌跡。
 Younes Hairej
KubeCon Japan 2025 は明らかな新しい現実を示しました。AIワークロードは現代のインフラの中心となり、Kubernetesはそのユニバーサルコントロールプレーンとして存在感を増しています。Bloomberg による本番環境での AI ゲートウェイの導入から、DaoCloud による6510億パラメータのモデルをマルチホストで推論実行する仕組みまで、この融合はインフラスタック全体を再構築しつつあります。
AIインフラの転換点
たとえば DeepSeek-R1 のようなモデルは、FP16では1.3TB、FP8でも651GBものVRAMを必要とするため、最適化以前の段階から複数ノード構成が前提となります。これは単に「大きなマシンが必要」という話ではなく、まったく新しいインフラカテゴリが誕生していることを意味します。東京で行われたセッションでは、AIアーキテクチャにおける本質的な変化が浮き彫りになりました。Bloomberg の Alexa Griffith 氏は、AIプラットフォームの進化を「3つの時代」に分けて紹介し、その変遷を示しました。
時代 | ワークロード規模 | 入出力 | データ構造 |
|---|---|---|---|
従来型 | 軽量 | JSON(矩形形式) | トランザクショナルDB |
予測型ML | MB~GB | テンソル | フィーチャーストア |
生成型AI | GB~TB | 流れるデータ | ベクトルDB |
まとめ
生成AI時代には、従来とは根本的に異なるインフラが求められます。
これまでのアプリケーションではCPUの性能やリクエスト処理数が指標でしたが、AIワークロードではGPUのオーケストレーション、トークン単位でのレート制御、そして分離型のサービングアーキテクチャが必要になります。
ここで本領を発揮するのが Kubernetes です。
単なるコンテナオーケストレーターにとどまらず、AIプラットフォームを構築するための土台としての役割が際立ってきています。
KubernetesにおけるAIの3つの次元
Aokumoでは、この融合を次の3つの視点で捉えています:
「Kubernetes上のAI」「Kubernetesの下にあるAI」「Kubernetesの中にあるAI」
この考え方は、インテリジェントでスケーラブルなインフラをスタック全体にわたって構築する、私たちのアプローチを表しています。
1. Kubernetes上のAI:ワークロードとアプリケーション
AIワークロードは、特殊な要求を持つコンテナです。规模なオブザービリティ、CI/CD、セキュリティ等はそのまま適用されます。
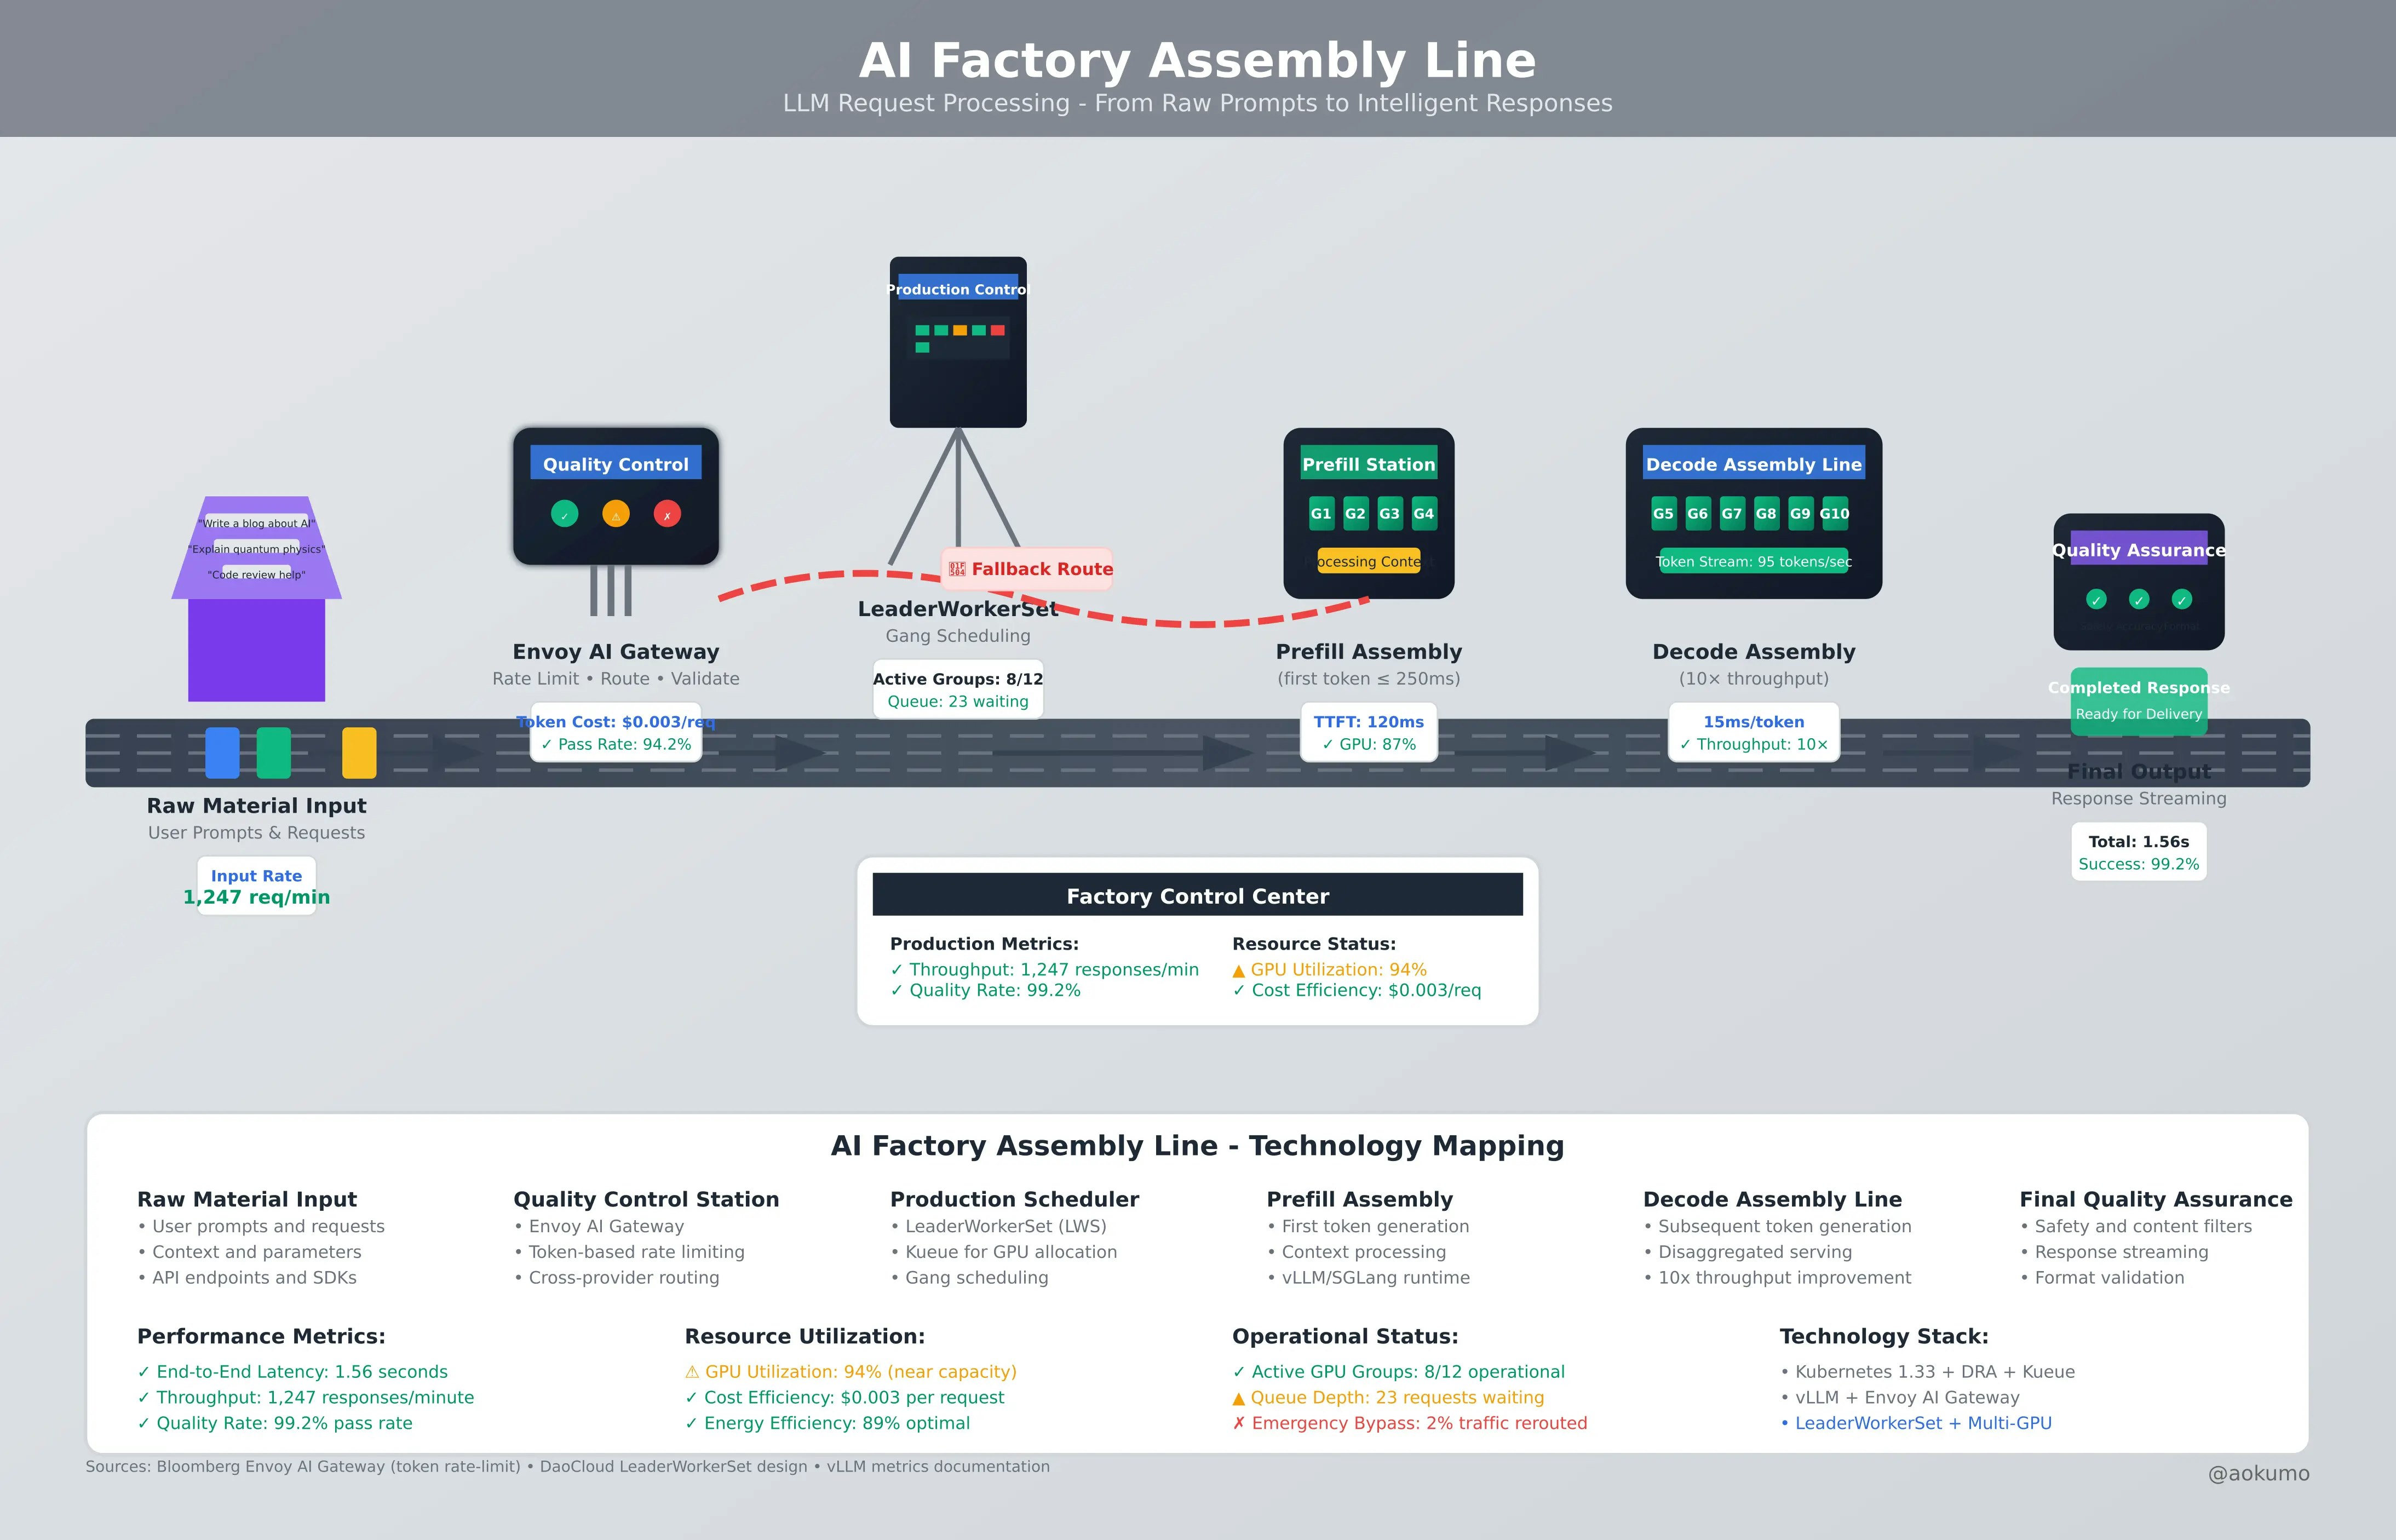
Bloombergは Envoy AI Gateway を用いて、LLMトラフィックを管理:
- OpenAI型APIで各プロバイダーを統一
- トークンに基づくレート制限
- 複数プロバイダーへのフォールバック
- LLMリクエストパターンに対する本番環境レベルの可観測性
重要な洞察:
「生成AIシステムの可用性を確保するには、レジリエンス(復元力)が不可欠だ。クロスリージョンやクロスモデルのプロバイダー間での“優先度ベースのフォールバック”が鍵になる。」
- Dan Sun(Bloomberg)
つまり、障害や遅延が発生してもサービスを継続できるように、優先順位に基づいて他のリージョンやモデルへ自動的に切り替える設計が、生成AI時代の信頼性を支えるということです。
2. Kubernetesの下にあるAI:ハードウェアとリソース管理
従来のCPU/メモリベースのスケジューリングは、複数ノードにまたがるGPUの分離型サービングや、複雑なトポロジー要件に対応しようとすると、機能しなくなります。
この課題に対し、DaoCloudの「LeaderWorkerSet(LWS)」が次のような仕組みで対応しています:
マルチホストにおける分散推論のパターン:
- リーダー・ワーカートポロジー:1つのコーディネーター(リーダー)と、複数のGPUワーカーで構成される構造。
- 自動環境変数の注入:たとえば LWS_LEADER_ADDRESS や LWS_GROUP_SIZE など、ノード同士の連携に必要な情報を自動的に設定。
- ギャングスケジューリング(Gang Scheduling):モデルを複数ノードに分割して実行する際に、必要なすべてのリソースが確保できなければジョブを開始しない「一括投入型」スケジューリング。
- トポロジーを意識した配置:ラック単位でのアンチアフィニティ(同じラック内に配置しない)により、障害時の影響を最小限に抑える設計。
このように、Kubernetesの下層でGPUリソースを効率かつ安全に扱うための高度な仕組みが求められています。
分離型サービングアーキテクチャにより、スループットが10倍向上(DaoCloud ベンチマーク、2025年6月)
これは、"prefillフェーズ"(プロンプト処理)と "decodeフェーズ"(トークン生成)を異なるGPUプールに分けて処理することで実現されました。各フェーズの特性に最適化されたリソース配置により、大幅な性能向上が得られています。
AIに特化した指標によるオートスケーリング
従来の「GPU使用率」では不十分なため、以下の LLM向けメトリクス を使ったスケーリングが推奨されています:
- vllm:num_requests_waiting:待機中のリクエスト数(GPUの使用率よりもスケーリング判断に有効)
- vllm:time_to_first_token_seconds: 最初のトークンが返ってくるまでの時間(ユーザー体験の指標)
- vllm:gpu_cache_usage_perc: GPUキャッシュの使用率(キャッシュ逼迫による性能低下を防ぐ)
3. Kubernetesの中にあるAI:プラットフォーム統合
AIプラットフォーム全体をKubernetesに組み込む:
- Kubeflow Training Operator 2.0 (分散訓練)
- KServe (本番提供のサービング)
- Ray Data (データストリーミング)
完全な機械学習ライフサイクルには「推論」だけでは不十分
Kubeflow エコシステムの進化は、Kubernetes がエンドツーエンドのAIプラットフォームの基盤となることを示しています。
Training Operator 2.0(DeepSpeedをネイティブサポート)
- マルチノード/マルチGPUでの分散学習が可能
- フレームワーク非依存:PyTorch、JAX、MLXなど幅広く対応
- Kueueとの統合により、GPU資源を「公平に割り当てるスケジューリング」が実現
KServe(本番環境での推論サービング)
- 分散型KVキャッシュ(LMCache)によってLLMの推論性能を向上
- Envoy AI Gatewayとの統合で、さまざまなプロバイダーに対する一元的なトラフィック管理が可能
- AI専用メトリクスに基づくオートスケーリングにも対応
Ray Data(データストリーミング課題の解決)
- 大規模データセットを学習する際のCPU/GPUリソース使用を最適化
- メモリ不足時のクラウドストレージ経由の無駄なディスクI/Oを排除
- 分散GPUノード向けにストリーミングインターフェースを提供し、スループットを最大化
本番運用パターン:実際に効果がある取り組みとよくある落とし穴
よくある失敗例(Common Gotchas)
- CPUベースのオートスケーリング → GPUリソースの無駄遣い
- トークン単位のSLO(サービスレベル目標)不設定 → キューが隠れて遅延発生
- LLMキャッシュの不一致 → 突発的なレイテンシスパイク
1. マルチクラスターAIオーケストレーション
パターン:複数クラスタにAIワークロードを分散させ、レジリエンス向上、コスト最適化、地理的分散を実現。
実装例:
- 中央集権的なAIゲートウェイとスケジューリングを担うハブクラスタ
- 専用ハードウェア(GPU種別やメモリ構成など)を備えたワークロードクラスタ群
- Cilium ClusterMesh を用いたクロスクラスターのネットワーク連携でモデル連携を実現
2. 容量認識ルーティングとオートスケーリング
課題:GPUリソースは高価かつ限られているため、CPU指標に基づく従来のオートスケーリングは失敗しやすい。
解決策:
- キューの深さを監視し、GPU利用率ではなく num_requests_waiting に応じてスケール
- トークンスループット最適化:モデルの処理能力に合わせてリクエストをルーティング
- コスト意識のあるスケジューリング:性能とGPUコストのバランスを取る
3. モデルライフサイクル管理
推論だけでなく、実運用AIプラットフォームに必要な要素:
- モデルのバージョン管理やA/Bテスト機能
- カナリアデプロイによるモデル更新の段階的適用
- モデル性能が低下した際のロールバック戦略
- 共有インフラ上での複数モデル同時サービング
4. エンドツーエンドの可観測性
AI特有の重要なメトリクス:
- トークンテレメトリー:入出力トークン数やリクエストごとのコスト
- プロンプト系譜:リクエストがシステム内をどのように流れたかの追跡
- 幻覚(ハルシネーション)検知:生成結果の事実確認と整合性チェック
- 生成AI向けSLO:最初のトークン応答時間やトークン処理速度
AI対応プラットフォーム構築ロードマップ
(KubeCon Japan 2025で示されたパターンをもとに)
フェーズ1:基盤構築
- GPUリソースに配慮したスケジューリング環境を整備
- Kueue の導入による公平なGPU割り当て
- Dynamic Resource Allocation (DRA) で細かなGPU制御を実現
- NVIDIA GPU Operator を使ったハードウェア管理
- 複数GPUを使うワークロード向けのトポロジー認識スケジューリングの設定
フェーズ2:インテリジェントなトラフィック管理
- AIに特化したネットワーク機能を追加
- Envoy AI Gateway を導入し、LLMトラフィックを一元管理
- プロバイダー間のフォールバック(セルフホスト → クラウド)設定
- トークンベースのレート制限(コスト計算式を適用)
- トークンメトリクスやキューの深さなど、AI特有の可観測性を設定
フェーズ3:高度パターンの導入
- 本番ワークロード向けにスケールアップ
- LeaderWorkerSet を使ったマルチホストモデルサービングの導入
- 大規模モデル向けの分離型サービングの構築
- Kubeflow Pipelines による機械学習ライフサイクルの自動化
- Ray Data を用いた学習データの最適化
フェーズ4:プラットフォーム統合
- 開発者体験の充実と運用基盤の完成
- KServe による本番推論環境の構築
- マルチクラスターAIオーケストレーションの実装
- モデルライフサイクル管理の整備
- エンドツーエンドのAI可観測性スタックの追加
戦略的な意味合い
この変革が重要なのは、単なる技術的な進歩だけでなく、経済的・運用的な優位性をもたらす点にあります。
大規模コスト最適化
- 分離型サービングによりGPU効率が10倍に向上
- 動的リソース割り当てでGPUのアイドル時間を削減
- マルチプロバイダーフォールバックでベンダーロックインとコストを軽減
開発者生産性の向上
- 統一APIによりプロバイダー差異を抽象化
- Kubernetesネイティブのワークフローで既存のCI/CDを活用
- 宣言的なモデルデプロイで運用負荷を簡素化
エンタープライズ対応力
- ミッションクリティカルなAIワークロードに対応するマルチクラスターレジリエンス
- KubernetesのRBACによるコンプライアンスとガバナンス強化
- 標準化APIによるベンダー独立性の確保
これからの展望:AIネイティブプラットフォーム
AIとKubernetesの融合は、単なる技術の進化ではなく、今後10年のコンピューティングを形作るAIネイティブプラットフォームの基盤です。
KubeCon Japan 2025での主要な兆候
- CNCFプロジェクトがAIワークロードパターンにますます注力
- ミッションクリティカルなAIアプリケーションの企業導入が加速
- AI APIやプロトコルの標準化の動き
- オープンソースの革新による急速な進展
プラットフォームチームにとっての大きなチャンス
今、AI対応のKubernetesプラットフォームを構築する組織は、AIワークロードがインフラ需要の主役になる未来において、大きなアドバンテージを手にします。
もはや「AIワークロードをサポートするかどうか」ではなく、「それに備えられているかどうか」が問われる時代です。
さらに学びたい方へ
- Envoy AI Gateway ドキュメント(APIリファレンス・導入ガイド)
- LeaderWorkerSet設計文書(マルチホスト推論アーキテクチャ)
- Kubeflow Training Operator 2.0(DeepSpeed・分散学習対応)
- KServe 0.15 LMCacheブログ(KVキャッシュ最適化技術)
- CNCF GPUワーキンググループ(Kubernetes GPUスケジューリング・DRAパターン)
あなたの組織ではどのようなAIワークロードパターンが見られますか?
AIネイティブな未来に向けて、どのようにプラットフォームを準備していますか?